
L3、端到端、VLA,这些智驾黑话都是什么意思?



不可否认,智驾已经是现在买车的一个重要参考因素,即便像华为ADS MAX高阶功能包(主要是城区智驾),选装要1.5万,但大部分车主还都是选装了。
对于从燃油车切换过来的消费者,可能对智驾并没那么了解,今天我们就来聊聊“L3”、“端到端”、“无图也能开”,这些“智驾黑话”到底是什么意思?
1
什么是智驾?
首先我们来看“智驾”这个词本身,目前我们所说的“智驾”指的其实是“智能辅助驾驶”,“辅助”这两个字在这里非常重要。
要注意的是,智驾≠自动驾驶,在达到L3之前,都只能叫智能辅助驾驶。
所以接下来的问题是,什么是L2?什么是L3?
2
什么是L2?L3又是什么?
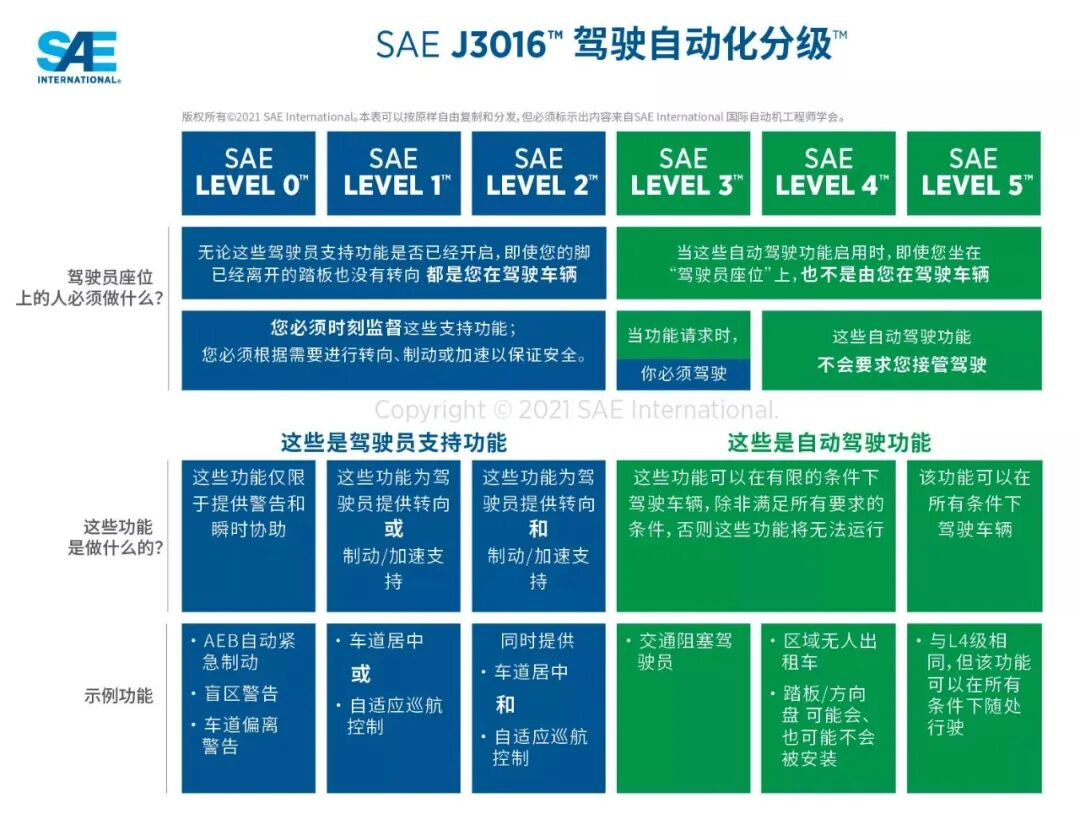
简单来说,这是一套“汽车驾驶自动化系统”的分级机制,分为L0-L5,一共六个等级。
其中国际上通用的是,美国汽车工程师学会(SAE)制定的标准。
国内则是由工信部牵头,在十余家车企的参与下,制定了《汽车驾驶自动化分级》标准,总体和SAE的标准差不多,但细节更保守和严苛。
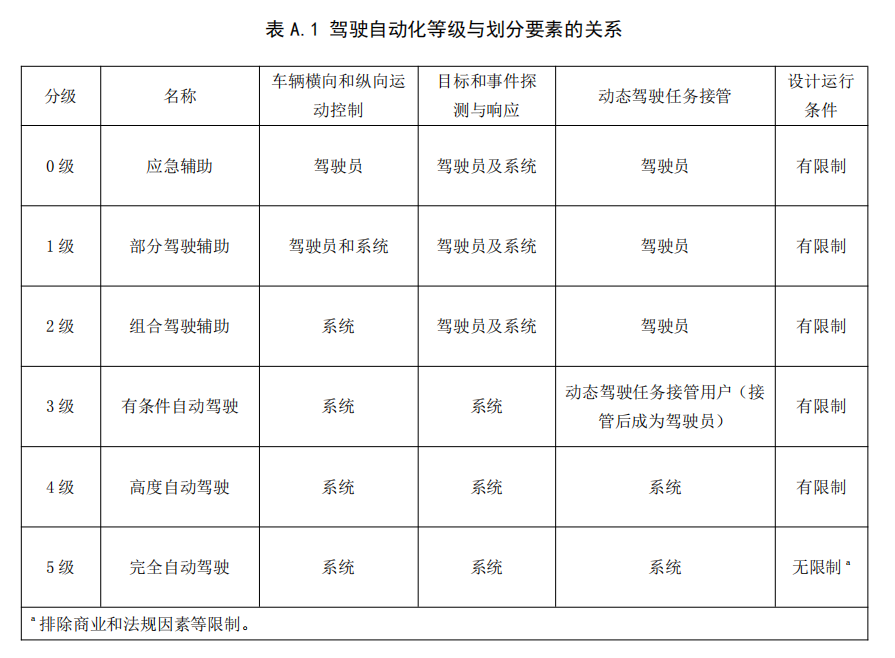
在这套分级标准下,L2及L2以下,只能叫“高级驾驶辅助系统(简称:ADAS)”,而L3及以上,才能被称为“自动自动驾驶(简称:ADS)”。
其中L3被称为“有条件的自动驾驶”,这里的“条件”是指在特殊条件下,仍需要驾驶员手动接管。
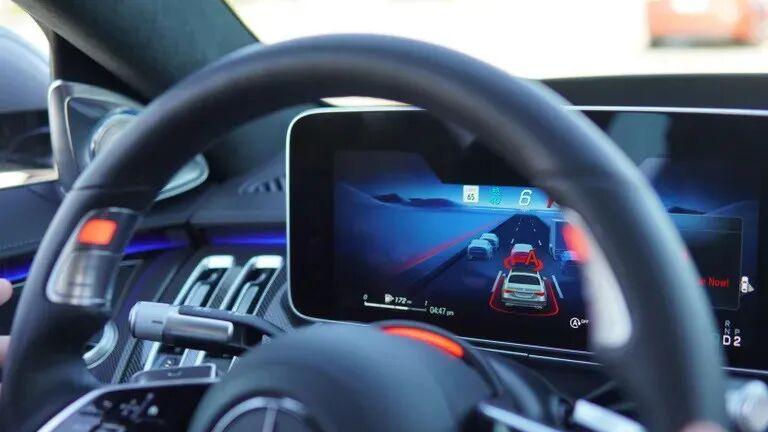
这似乎和当前的“智驾”没什么差别?但国标要求的是系统必须预留10秒钟的缓冲期,像那种发生事故前1秒智驾退出的甩锅行为将不被允许。
在L3级自动驾驶系统运行时,产生的违规违法行为,将会由厂商承担。
另外就是,L3级不是厂商说自己是,那就是,而是需要工信部认证。目前中国认证的搭载L3自动驾驶的只有深蓝SL03和极狐阿尔法S6的两款测试车,并且只能在特定的路段上可以开启。
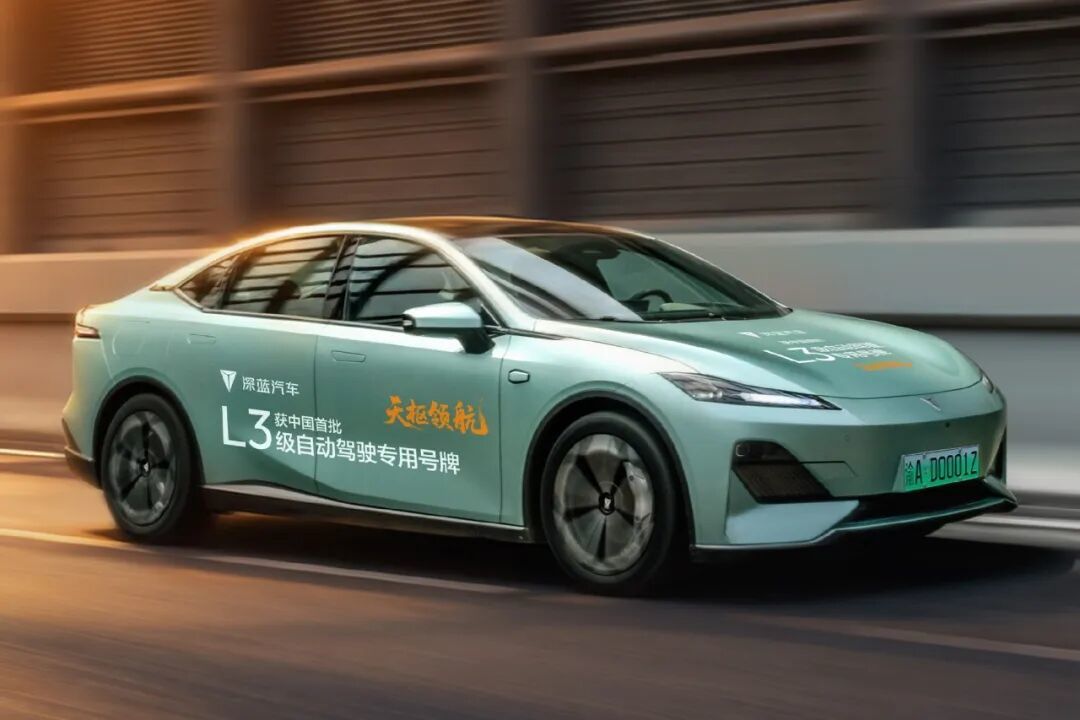
所以理论上来说,目前的厂商们的“智驾”,是不能称之为“ADS”的。
看到这里,应该有人反应过来了,那“智驾”应该还是“L2”才对?
确实没错,不过这就属于营销上的问题了。
3
智驾和L2有什么区别?
简单来说,在营销层面上L2这个级别又被细分为了:L2<高速智驾<城区智驾三个层级。< span>
其中“L2”指的是自适应巡航(简称ACC)+车道居中保持(简称LCC)功能,有这两项功能,意味着能实现在一个车道内,跟随前车加减速。
另外,配备了“L2”的车,一定会有主动刹车(简称AEB),毕竟前车刹车,你也必须刹车对吧。
不过反过来说就不成立了,有主动刹车的车,并不一定有L2,例如2021款丰田卡罗拉,全系标配主动刹车,但只有高配带L2。
而智驾,则是从自适应续航(ACC)升级为了“导航辅助驾驶”,也就是你设置一个导航目的地,系统会超车变道开到目的地。
至于简称,各个厂商的叫法略有不同,通行的叫法是“NOA”,像华为是称为“NCA”,小鹏是叫“NGP”,蔚来则是叫“NOP”。
在高速或快速路这些封闭路段才能使用的智驾就叫“高速智驾(高速NOA)”,而能在城区使用的智驾则叫“城区智驾”或“城市智驾(城市NOA)”。
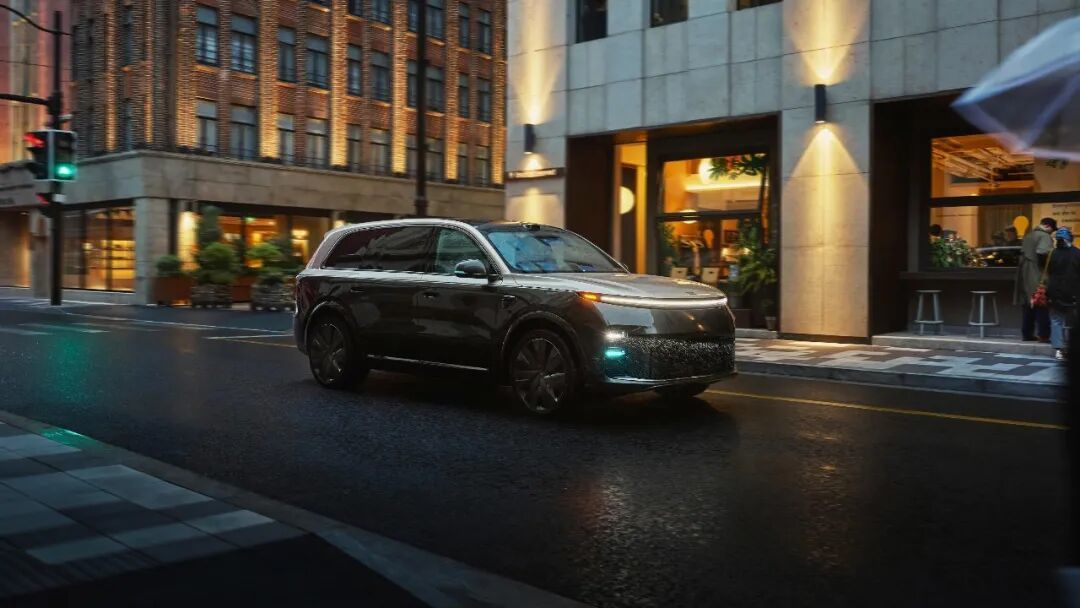
这里还是要提醒一句:智驾不是自动驾驶,目前的智驾随时可能退出,所以使用智驾也必须盯着路面,随时做好接管的准备。
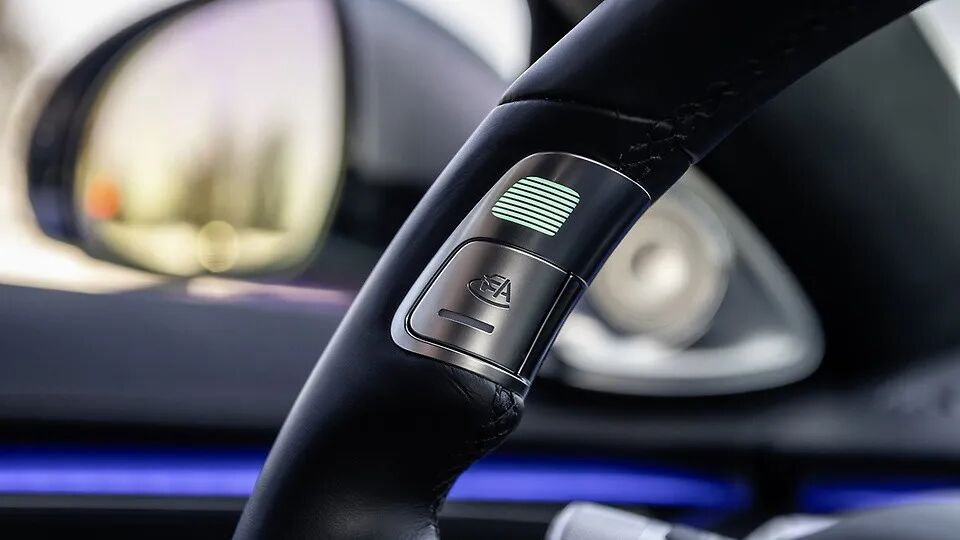
看到这里,对买车肯定已经够用了,简单来说L2能解放双脚,高速智驾能在高速和快速路上自主变道车超车,而城区智驾则是在城区路上也让智驾开,但无论是哪种一都必须随时接管,且发生违章和事故时,都是驾驶员的责任。
4
高精地图和无图的区别是什么?
很多厂商在宣传自己的智驾时,会说“无图也能开”,这里的“无图”是什么意思呢?
简单来说,以前智驾依赖地图供应商先扫描好的,包含车道信息的高精度地图。
但很多时候车道变更、加减红绿灯的信息更新得没那么快,所以更高阶的智驾能通过摄像头识别红绿灯、车道、路牌信息,不需要高精地图也能开。
要注意的是,很多智驾声称自己是“无图也能开”,但如果在一些修改了车道线的路口按原来的车道开,或是在新增的红绿灯闯了红灯,那大概率其实还是在依赖高精地图。
当然,“无图”不代表不需要地图,就和人类开车一样,智驾也是需要地图导航的。
5
端到端、世界模型、VLA又是什么?
最后再来看看智驾领域经常提到的三个技术概念:端到端、世界模型和VLA。
在了解它们之前,我们先简单了解一下传统智驾系统的工作流程。
传统智驾系统通常会通过摄像头、雷达等传感器获取周围环境信息,识别车辆、行人、车道线和交通信号等,再预测周围交通参与者可能的运动状态,结合导航路线和道路情况,规划接下来如何变道、刹车、加速,最后由控制系统执行相应操作。
而端到端(E2E),简单来说,就是让神经网络对驾驶任务中的多个环节进行联合学习,从传感器输入直接生成驾驶轨迹或相关决策输出。
它的优势在于,可以减少传统模块之间的信息损失,让模型利用大量真实驾驶数据学习复杂的驾驶策略。不过,端到端不代表反应速度一定更快,也不意味着模型每次都能生成最优解。
VLA(视觉—语言—动作模型),则尝试将视觉场景、语言相关的语义信息和动作决策结合起来。
比如,车辆遇到道路施工时,系统不仅需要识别前方有障碍,还需要理解道路环境和驾驶任务,并将这些信息转化为相应的驾驶决策。不过,VLA 并不是端到端的升级版,两者可以结合使用;它也不意味着系统一定能解释清楚每一个驾驶决策。
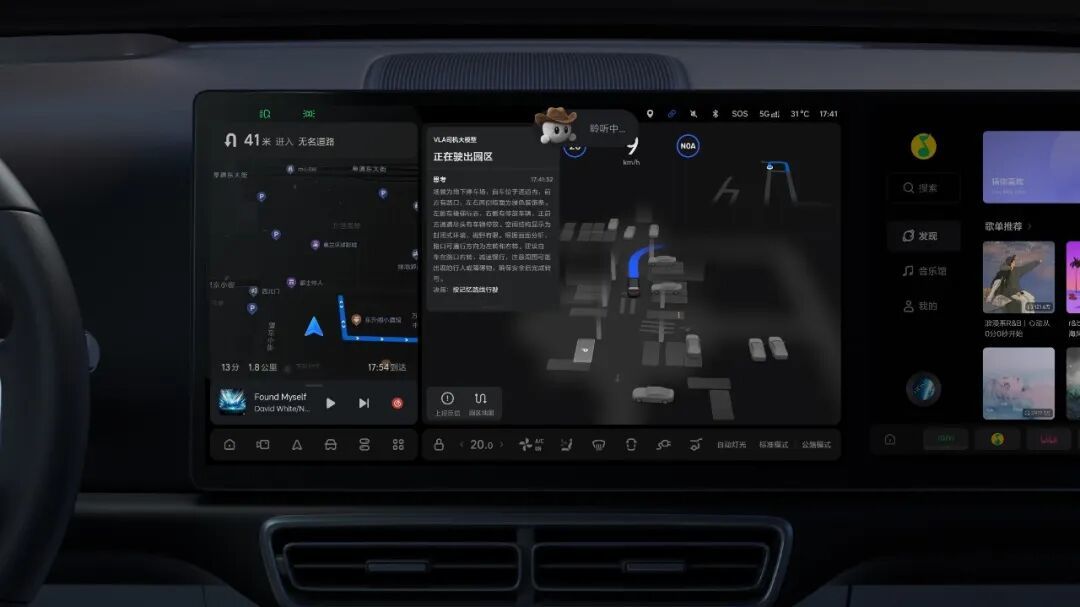
世界模型(World Model)则侧重于学习环境的变化规律,并预测未来可能出现的场景。
例如,看到路边有一辆自行车,系统可以预测骑行者为了绕开违停车辆,是否可能进入机动车道。进一步来说,车辆还可以在模型中推演减速、保持车速或绕行等不同方案,预测各自可能带来的后果,为驾驶决策提供参考。
当然,传统智驾系统同样可以预测其他交通参与者的运动。世界模型的特点不只是预测车辆和行人,还在于学习环境如何变化,以及不同动作可能导致怎样的未来状态。具体实现可以是预测未来画面,也可以是预测车辆位置、空间占用或其他环境状态,并不一定要建立多个完整的“虚拟世界”。
需要注意的是,端到端、世界模型和VLA 并不是三条互斥的技术路线。端到端描述的是多个驾驶环节如何联合学习,世界模型侧重于环境预测,VLA 则强调视觉、语言与动作的结合。它们可以单独使用,也可以相互组合。
6
结语
作为普通消费者,其实不必过度纠结这些技术名词。最重要的知道:目前市面上大多数所谓的高速智驾、城区智驾,本质上还是驾驶辅助系统,随时都可能需要你接管。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”