
“算力之争”,谁在定义智驾算力?



一天前,新芯航途发布了那颗X7 Ultra。
通常国产芯片一发布就能收到有“格局”的同行们的祝贺,同时它也引发了不小的关注。
我们从头讲起。
重新定义的算力
这件事还得先从X7 Ultra独特的定位上来说。
就像苹果从买芯片到自研M系列,当科技大佬们想把持续进化的底层能力完全握在自己手里的时候,自研芯片就成了必经之路。
在蔚小理相继摆脱对英伟达的依赖以后,Momenta这家最早跑通英伟达芯片的厂商也拥有了兄弟公司为其打造的配套智驾芯片——X7 Ultra。
X7 Ultra是XHEART新芯航途的首款产品,CEO李宗霖原先是OPPO哲库的COO,2023年哲库解散后带着核心团队转入Momenta体系,随后芯片项目独立为新芯航途。
所以,这次的芯片特征几乎可以翻译成Momenta方案的“工作间”。
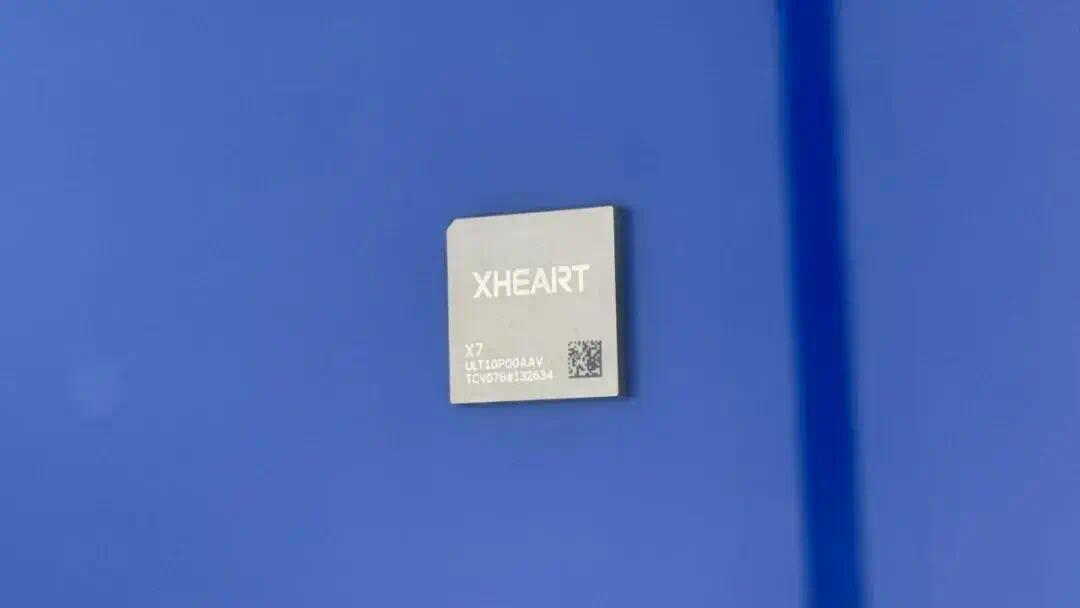
考虑到智能驾驶正在从小模型分工协作转向端到端大模型,他们直接打造了一个新概念——大模型芯片。
简单来说,以前的英伟达芯片为了各家都能用,提供的是一个通用的平台,主打可编程性。
而X7 Ultra设计的架构聚焦目标大模型的运转,“专”到极致。
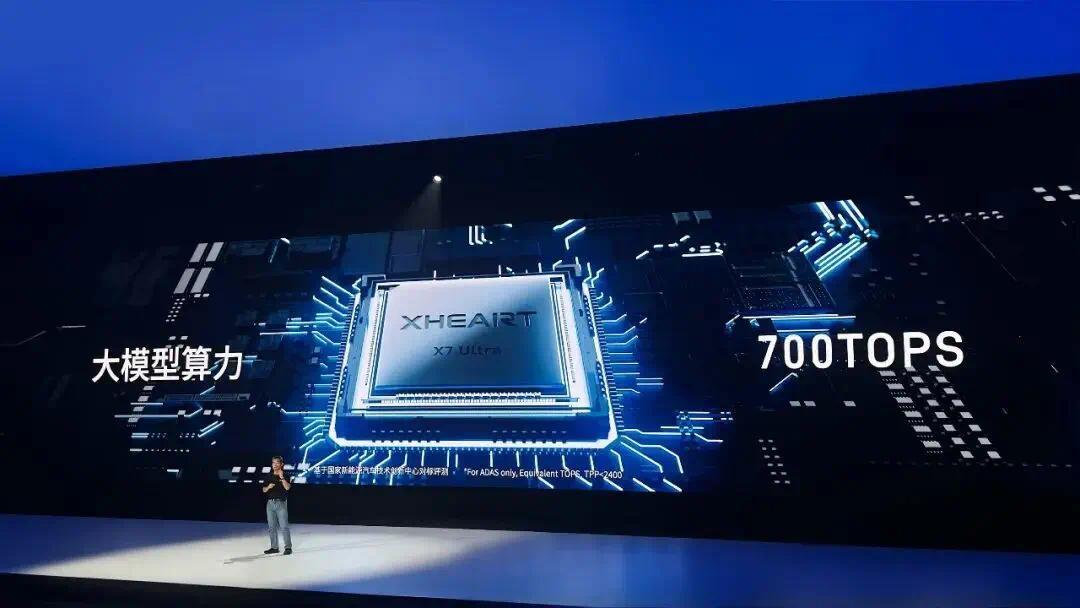
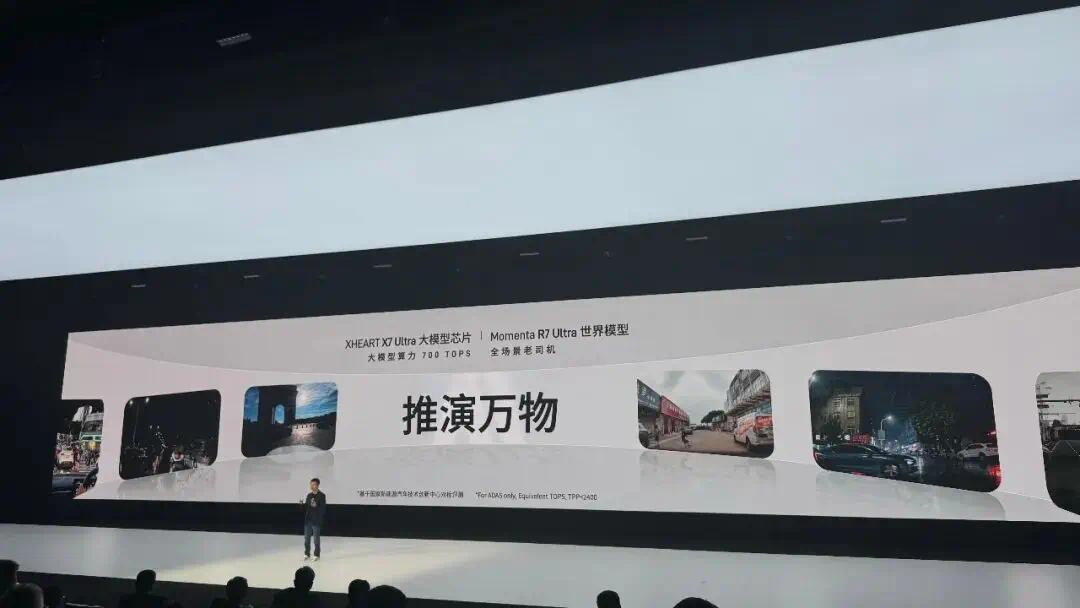
XHEART表示这颗芯片基于友商真实量产智驾大模型评测出能够达到700 TOPS的“大模型”算力。
“大模型算力”自然也是跟着“大模型芯片”一起诞生的新词,在影响行业格局之前,它在短期内先引发了第一个市场反应:迫使其他厂商重新解释自己的算力。
都是“算力”,为什么同样的产品能给出不同的数字?
简单来说,算力就像脑力一样,有些弹性。
比如我想表达脑力,可以用我1小时内做多少道10以内的加减乘除题或者是多少道二元一次方程题来形容。
到算法上,也要考虑在INT8、FP8、FP16等不同运算精度的情况下,它分别“每秒可以进行多少万亿次运算”。
所以算力是有前提条件的,得看这个数字是在什么难度的题目上测出来的。
而且行业内通常还会分“稠密算力”和“稀疏算力”,后者通常被形容为前者2倍。
打个比方,1页纸上有100道题,1分钟能算完,这就是你的稠密“脑力”。
这时候你发现每100道题目里有50道题目都是“0”和另外一个数字相乘,你直接略过,又多算了一页,现在1分钟能算200道题,这就是你的稀疏“脑力”。
由于算法可以通过剪枝的方式减免一些步骤,“稀疏算力”就有更好的表现。
此前,各家用不同的精度、不同的稀疏化假设来“对齐”英伟达的框架,数字才有了一个勉强可比的基础。
那么X7 Ultra的700TOPS大模型算力是什么意思呢?
再打个比方,英伟达的芯片不管是部教版还是统教版等等都能接受,谁都可以收这个学生回去培养,而X7 Ultra优先奔着沪教版去学,围绕目标教材优化,让它考这套教案就能拿到“700”分。
以Momenta的大模型为例,X7 Ultra跑这套模型的能力大概和700TOPS算力的英伟达Thor U一样,也就是说在X7 Ultra擅长的领域,它能发挥出700TOPS的等效大模型算力。
换句话说,这不是一颗通用芯片在标准基准上的峰值算力,而是一颗专用芯片在特定模型上的“等效表现”。
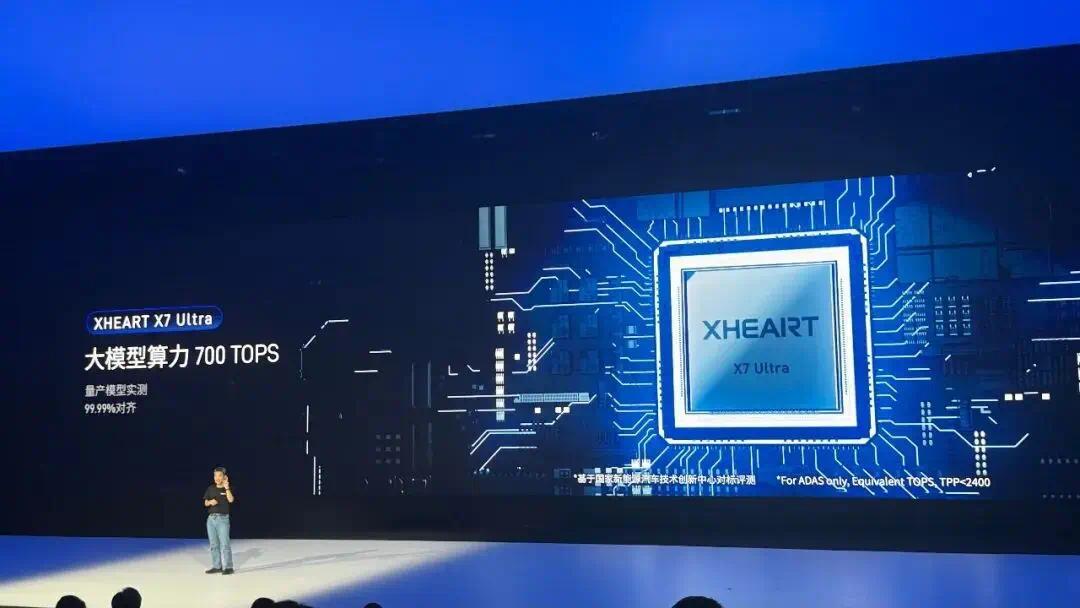
当然,毕竟X7 Ultra是一颗电子产品,除了跑友商模型测出来的实力,它得有个总处理性能数据。
所以在X7 Ultra的发布会PPT上,我们可以看到右下角有这么一行标注:TPP小于2400。
TPP是一条偏向出口管制与供应链合规的说明,美国出口管制就用这样的规则来衡量芯片计算能力。但这里划个小重点,TPP仍然不能和大家发布会上常见的TOPS画等号。
只是从数学角度的上限推算,按照TPP的逻辑,除以运算精度就能得到X7 Ultra的性能算力。
比如在INT8精度下,X7 Ultra对应的稠密算力小于300TOPS,稀疏算力小于600TOPS。
在FP16精度下,X7 Ultra对应的稠密算力小于150TOPS,稀疏算力小于300TOPS。
在这里给个参考,英伟达Thor U的700TOPS算力,按此前搭载该芯片的理想汽车官方口径是在INT8和FP8混合精度下测算出来的。
按照“大模型算力”的说法,XHEART表示2027年要推出3000TOPS的大模型芯片X9,单芯片内存带宽700GB/s。
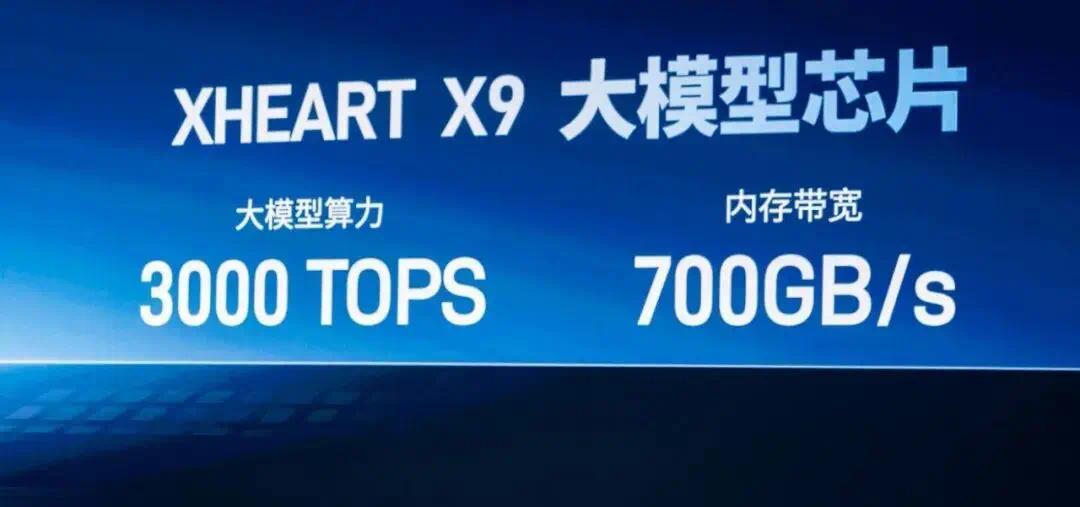
光看数字的话,这家芯片新星确实看起来呈现碾压之势,而算力的解释成本又比较高,也难怪行业突发争论。
实际上这也是芯片行业长久以来关于标准口径矛盾的一次体现,比如华为就曾表示MDC芯片官宣算力比不少同行都要低,但实际能效是更高的。
可能也是这个原因,现在搭载华为乾崑方案的车都不再展示算力配置,只管“比疗效”。
那么从专属“疗效”来看,X7 Ultra是怎么做到等效700TOPS的?
为什么敢这么标?
如果只把X7 Ultra的标法看成营销话术,会错过它真正有分量的部分。
这颗芯片的架构选择,确实在努力回答一个难题。
从大模型的工作流程上出发,X7 Ultra打造了一套计算链路更集中化的架构。
最有代表性的是超大核NPU。
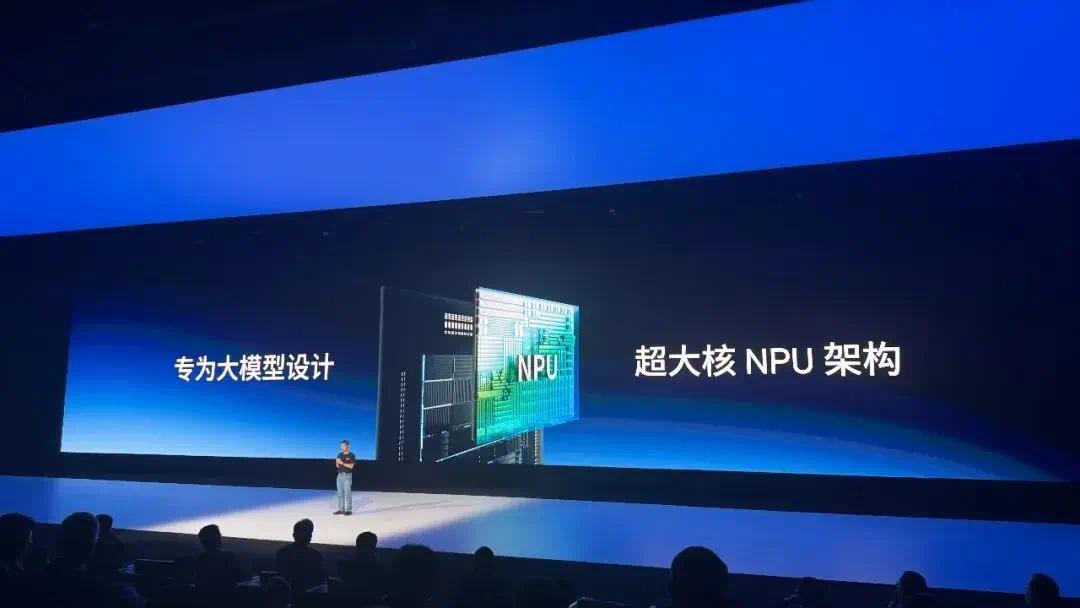
在芯片的架构中,NPU是最核心的计算区域,如果用厨房来比喻芯片,那么NPU就相当于灶台。
常见的多个小NPU核心类似于多组合作,这种路线并不天然低效,但分工以后难免要来回搬运数据。
超大核的目标是让更多计算和中间数据在核内完成,最直接的好处是减少了“交接和运输”。
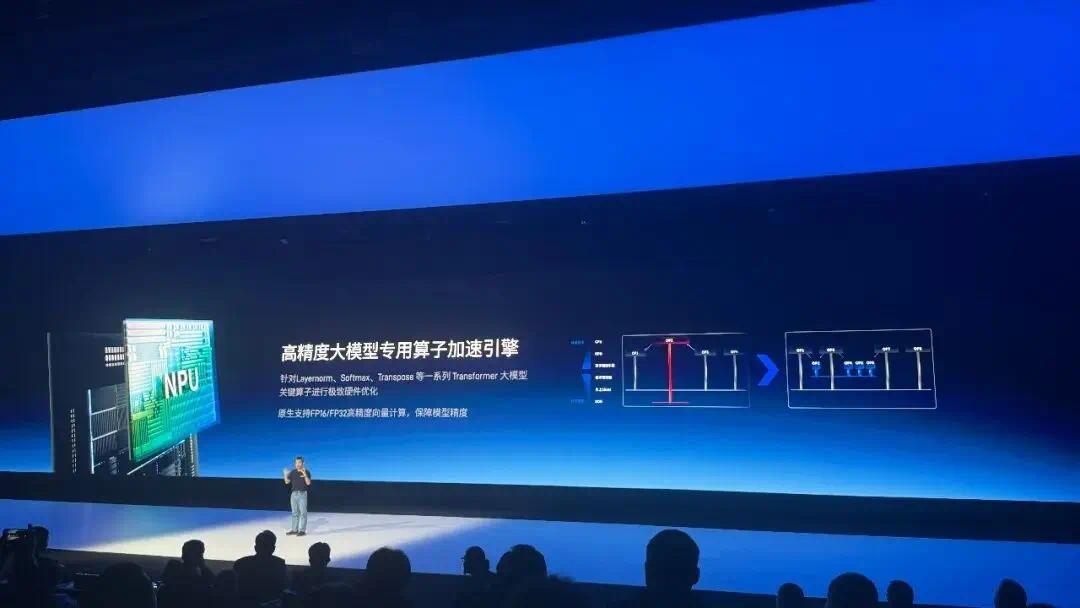
大模型的计算过程分很多步骤,每个步骤都称为一个“算子”。
为了让计算更顺畅,X7 Ultra针对关键部分的算子提供了专用加速,这同样是有了具体大模型运行目标以后做配套的手段,也就是排查流程中容易拥堵的地方再给开个“通道”。
下一个问题是如果灶台上的菜已经炒完了,下一盘备菜还没切好,就会产生空档期,拖慢进度。
所以X7 Ultra的计算与权重加载并行,这一批数据正算着呢,下一批权重就加载好了。
除了核内计算,模块交接也影响效率,各个模块在交接数据时都建立自己的副本的话,就会增加工序时间且占用内存。
X7 Ultra的解决办法是通过AI工具链实现整网级融合,减少的是中间结果反复写出、读取外部内存。
再减少同一份数据在不同模块之间交接时建立重复副本的操作,比如某些模块可以共用一个内存区域,我放到这里,你来这个位置读取使用。这就是“零拷贝”。
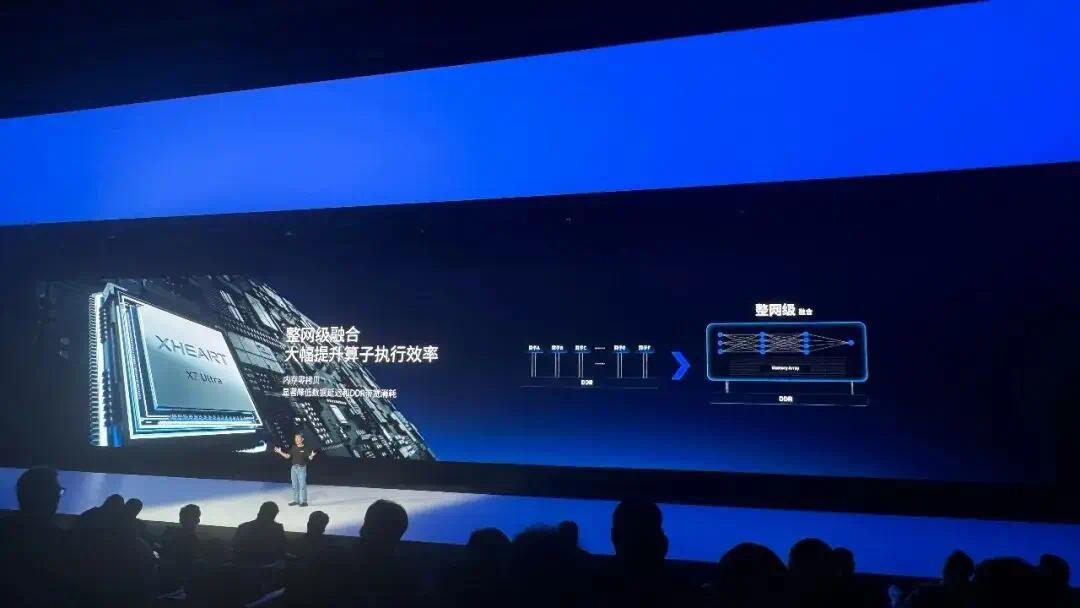
以上所有技术都指向一个目标:让NPU尽量少等待,把更多时间用在有效计算上。
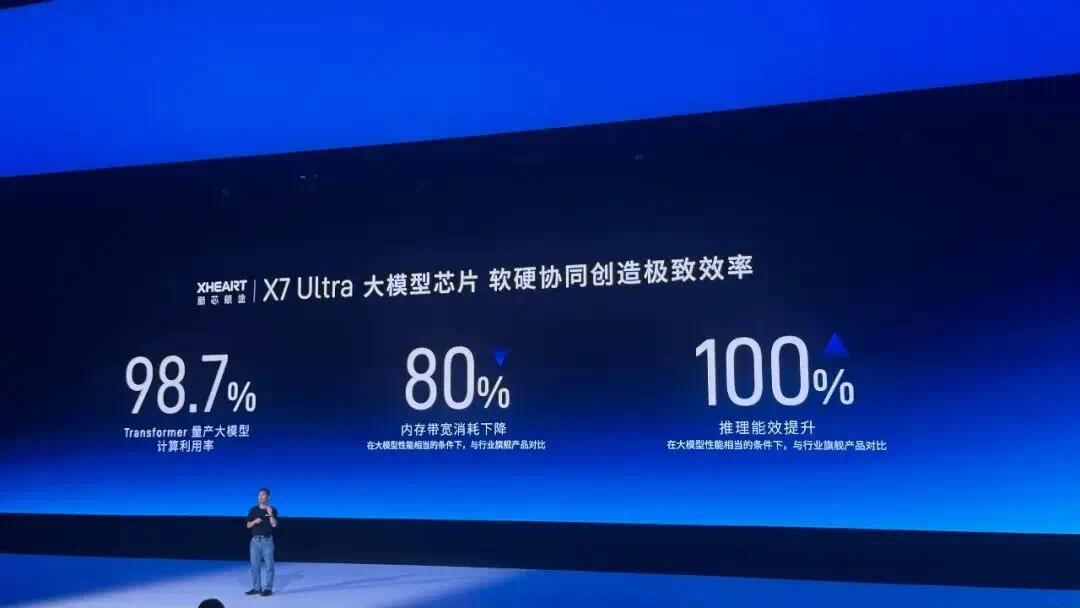
综合下来,基于量产智驾大模型实测,X7 Ultra NPU计算利用率的官方数据能达到98.7%。
另外官方表示X7 Ultra 的内存带宽消耗较“行业旗舰产品”下降80%,这也是由前面这些技术带来的成果。
如果说别人完成同一任务需要搬运100份数据,X7 Ultra通过复用、融合和减少复制,只需要搬运20份。
大模型计算只是智驾系统的一部分。要真正进入车辆,芯片还需要处理系统调度、传感器输入和功能安全。
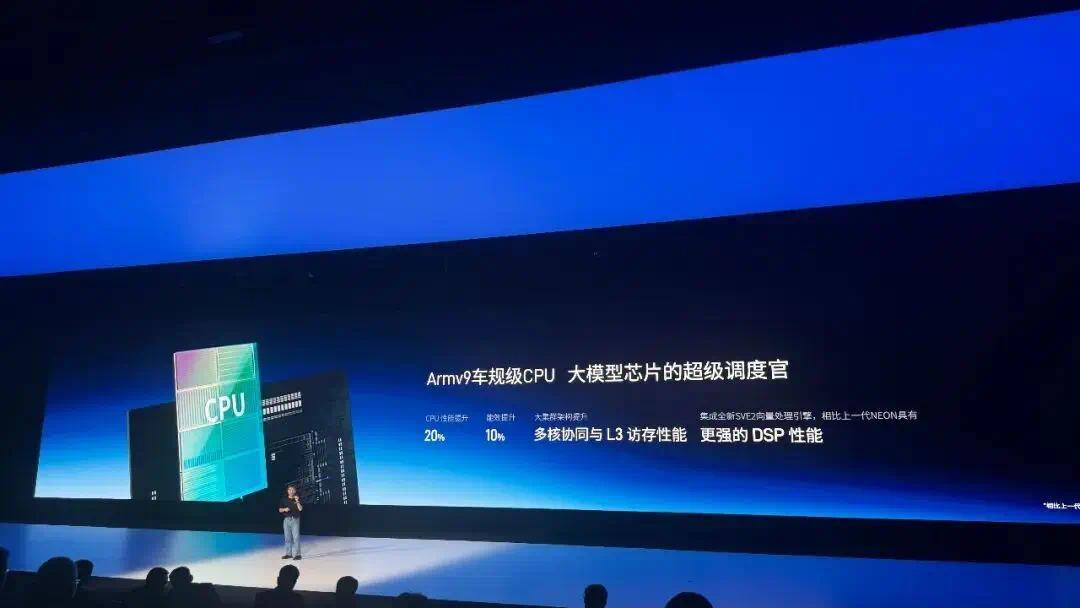
为了让芯片上的软件与CPU顺畅沟通,X7 Ultra采用了Armv9指令集架构。
它相当于一套统一的“语言规则”,软件经过编译后,会变成CPU能够理解和执行的指令。
CPU再运行操作系统和调度程序,承担通用计算、任务调度及部分复杂控制工作。
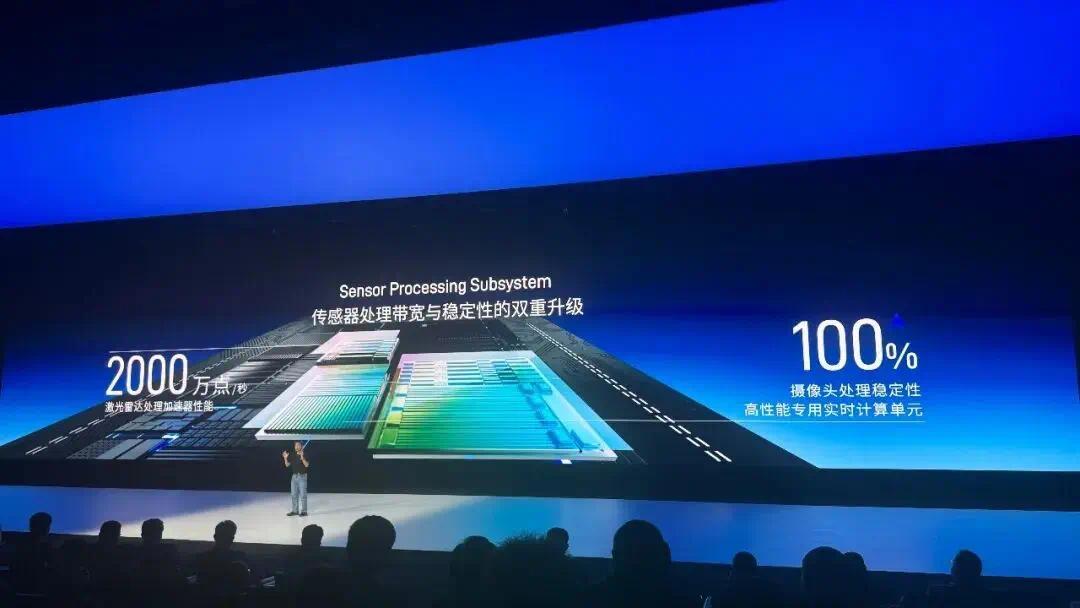
在传感器侧,通过专用单元承担激光雷达及传感器预处理,先把原始数据处理成后续模型可以使用的输入,而不是把所有任务都压给NPU。
据说X7 Ultra的激光雷达处理能力最高可达每秒2000万点。
在安全方面,X7 Ultra 的SoC满足行业标准的ASIL-B要求,内置的承担监控、状态管理和故障处置等任务的MCU通过ASIL-D认证。
量产才是唯一的裁判
虽然X7 Ultra在宣布时一直强调是基于“友商大模型”测算,没有提名字,但也没有人会猜测Momenta以外的方案了。
更何况芯片一发布,Momenta就预告了基于X7 Ultra的R7 Ultra大模型,模型参数规模扩大5-10倍,安全性能提升5-10倍以上,将从“理解世界”走向“推演世界”。
所以起码短期之内,X7 Ultra会被套上Momenta专用芯片的身份,就Momenta的订单量来看,这也是好事。
不过XHEART作为独立公司,肯定还是有市占量的目标,那它的发布会带来哪些影响呢?
除了让大家对算力数字更敏感以外,它也许会带动芯片竞争更多落到真实模型上。
对英伟达来说,虽然X7 Ultra动摇不了它的通用生态和开发工具优势,但可能会丧失一些老客户。
尤其原本选择Momenta软件、英伟达芯片这套方案的车企,在评估了X7 Ultra以后发现在目标模型上确实更省电、成本更低,那很难不选择国产了。
这也是Momenta和X7 Ultra联手的最大成果,可以用模型与芯片联合定义辅助驾驶系统。
对地平线、黑芝麻等国内平台竞争会更直接,因为大家都在讲适配于Transformer和大模型,也在讲减少数据搬运以提高计算速度、降低系统时延的优势,比如黑芝麻的九韶架构。
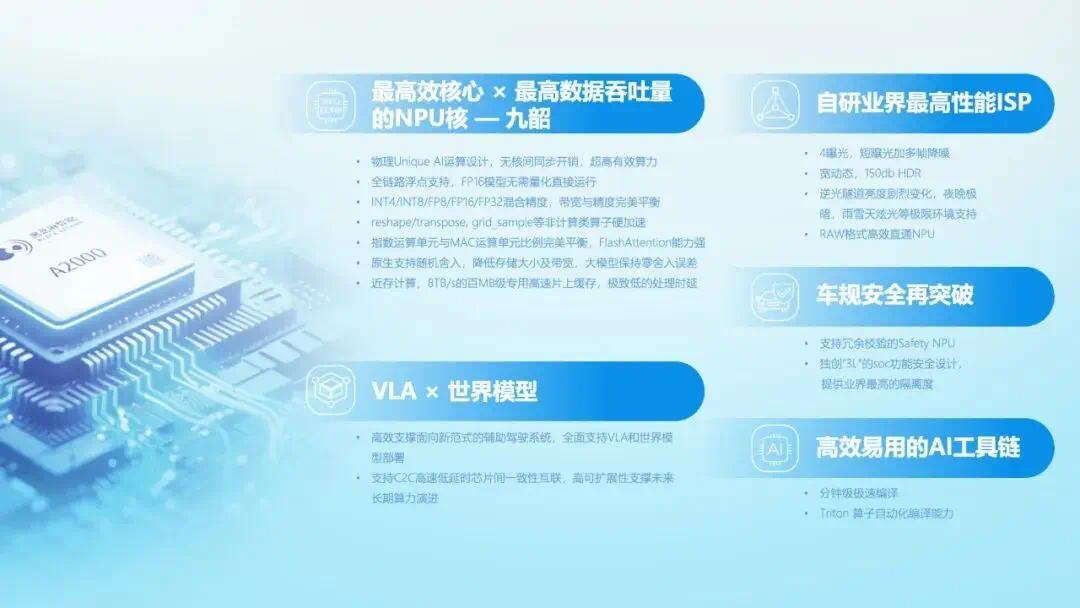
相对来说,有自研软件系统的地平线可能更有说好这套故事的潜力。
现在作为都有软件系统和自研芯片的辅助驾驶供应商,华为、地平线和Momenta接下来也难以避免被比较。
不过这三家区别还是很大,华为主推包括MDC在内的乾崑整体方案,地平线既开放芯片平台也提供HSD,XHEART与Momenta则展示了芯片公司与算法公司深度组队的路线。
华为和地平线都是先有芯片再有方案,目前来看迭代系统很丝滑。
而Momenta的方案目前有不少是搭载在英伟达、高通芯片上的,相比未来搭载X7 Ultra的车型,可能迭代上要多花费一些精力。
写在最后
不过无论行业如何看待,对车企而言,最终需要比较的也不只是一个700 TOPS,而是同等功能下的实际表现、成本、功耗、开发周期和量产稳定性。
所以,X7 Ultra的发布只是开始。
它已经让行业重新讨论算力该怎样表达、芯片该由谁定义;接下来,则要由真实车型回答这些问题。
700 TOPS可以引发争论,量产才会回答争论。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”